EchoFlow
用跟讀法練任何自己想練的英文素材。面試自介、旅遊常用句、上台的講稿都能匯進來,開口念的時候,畫面上的字會跟著聲音逐字由淺變深。我自己拿來練英文口說的網頁 App。
- Python
- FastAPI
- WebSocket
- AssemblyAI
- React
- TypeScript
- Cloud Run
- Firebase
- GitHub Actions
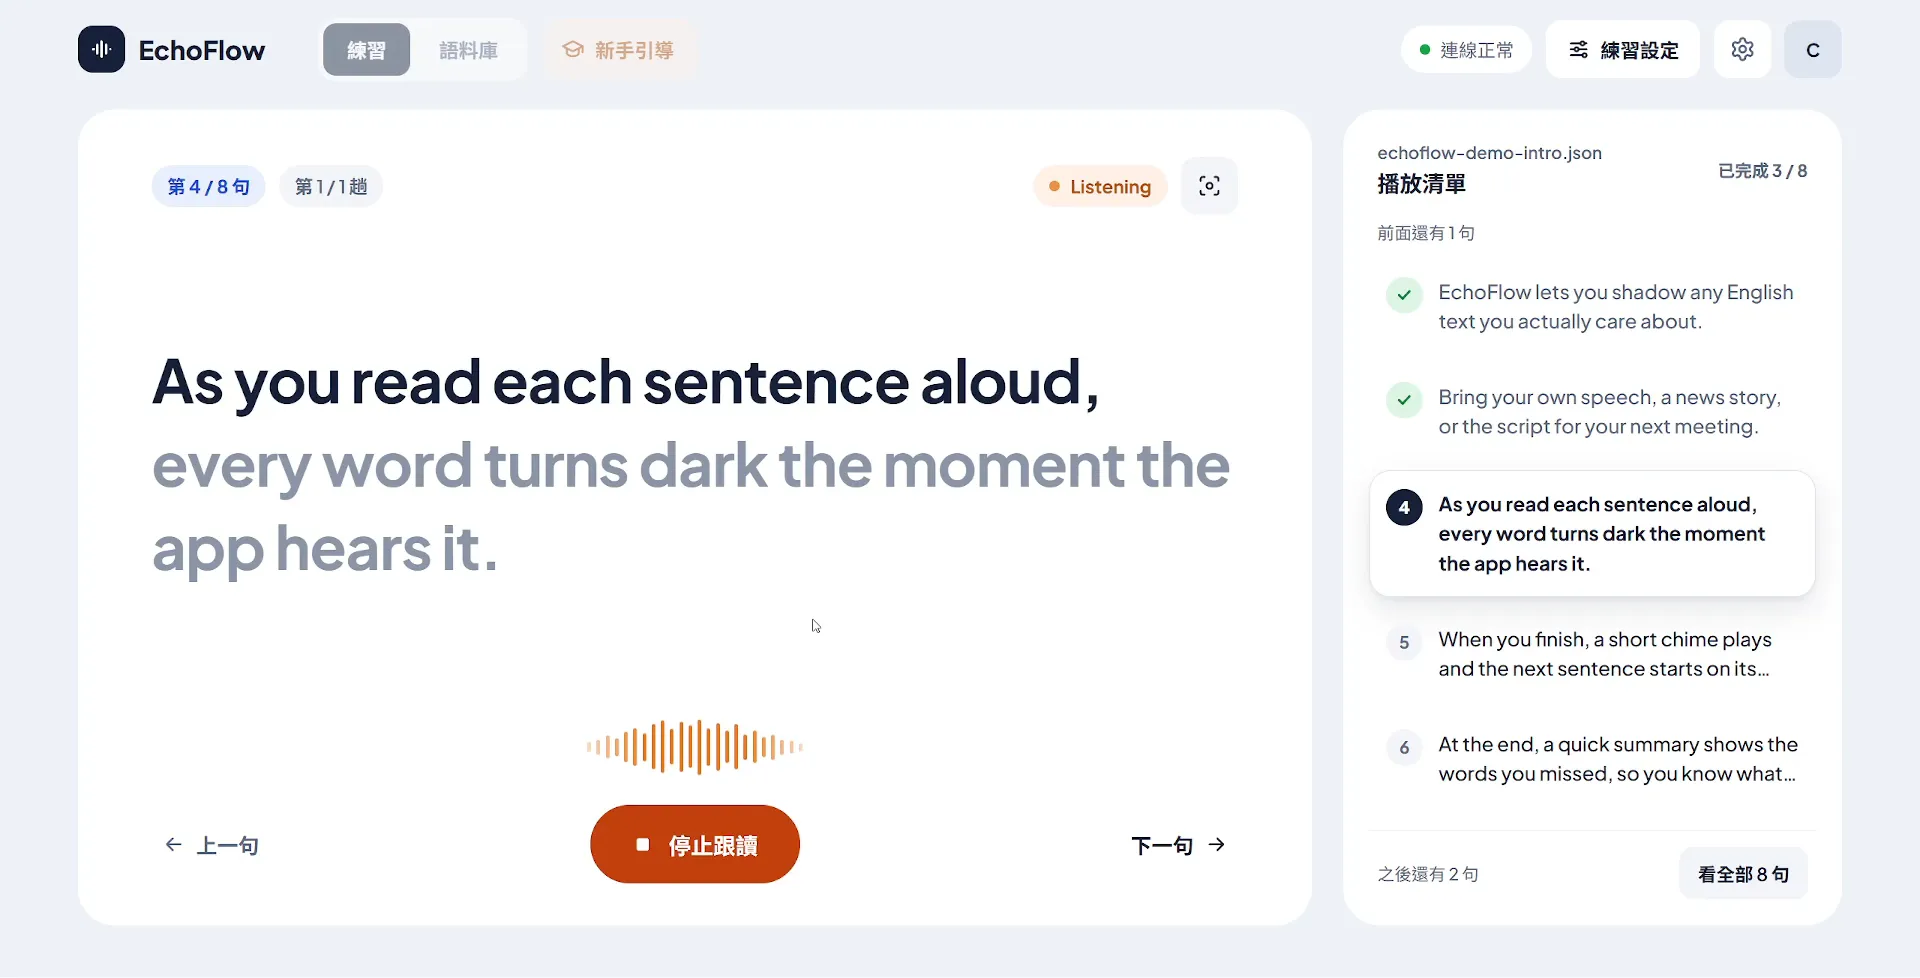
EchoFlow 是我拿來練英文口說的跟讀(shadowing)網頁 App。開口念的時候,畫面上的字會跟著我的聲音逐字由淺變深,像唱卡拉 OK 一樣;而最重要的是,讓練習的內容完全由我決定。
在自己動手做之前,我從 2026 年 2 月下旬開始,用了四、五個月的 Speak。
這是一款 AI 語言學習 App,提供大量主題式的課程材料還有影片課程,並引導使用者用跟讀法,把句子一句一句念出來,念的時候畫面上的字跟著聲音變色。這種跟讀的練法,一方面鍛鍊嘴巴的肌肉記憶,一方面讓腦袋熟悉文法與句型。練了這段時間,我很確定這個方法對我有效。
但在用了好一段時間後,我開始覺得 Speak 最大的限制是練習材料基本上就是按照它設定好的課程。即使 Speak 的語音辨識和逐字對齊已經做得相當好,但不能拿來練自己想練的內容;App 裡面雖然有 AI 自訂課程,但實際用起來生成的內容通常只有幾句,而且只能給方向,不知道 AI 會如何生成。
既然跟讀法對我來說有用,我就在想,能不能把自己想練的內容,例如特定文法的例句、自己整理好的一段故事、面試的英文自我介紹,也用同樣的方式練?
我想自己把這個缺口補起來:做一個一樣能跟著聲音變色的跟讀 App,但素材由我自己決定,讓我在手機與電腦上都能隨時拿來練。(我對 Speak 的使用感想,在 Cambly 上課心得 裡有寫得更完整一點。)
用跟讀法,練任何自己想練的素材
想練什麼,就把它變成講稿
講稿本身的格式其實很簡單,就是一個特定格式的 JSON 文件。但要把一篇自我介紹或者演講稿切成適合跟讀的單句,這個工作如果要手動處理還是非常麻煩。
因此我整理了一個 Agent Skill,把格式規則與切句的風格建議寫成給任何 AI Agent 的說明。這樣一來,不論是使用哪個 AI 工具,甚至網頁版的 AI 聊天,只要給它這份 Skill 和想練的內容,就能整理出 EchoFlow 用的講稿。
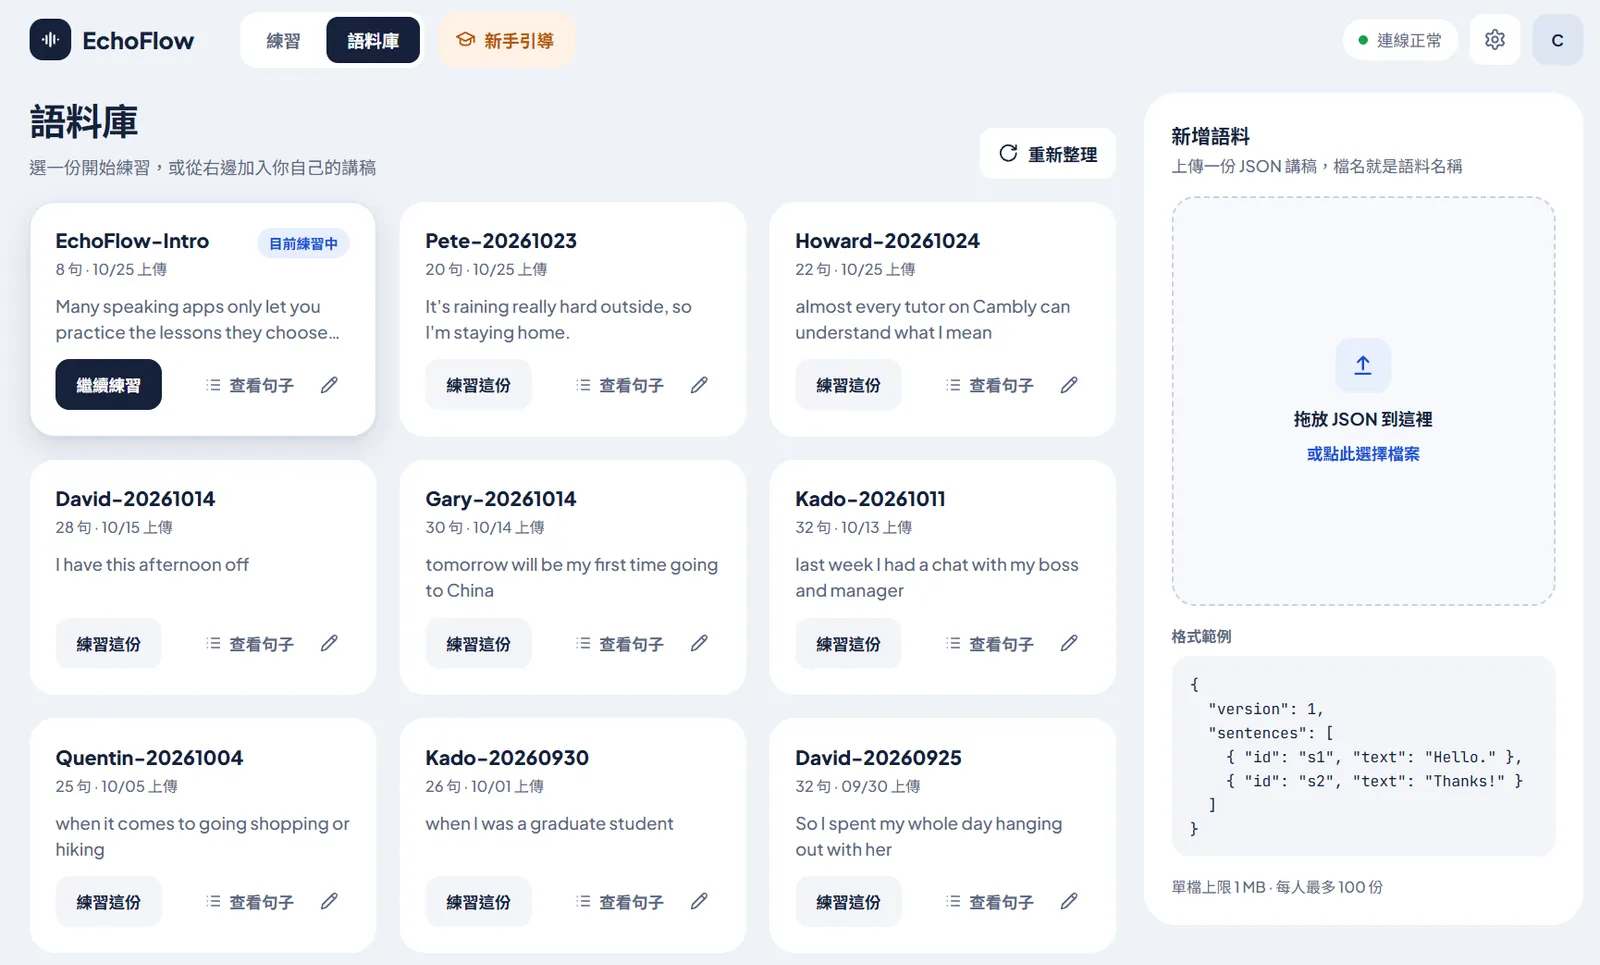
整理好的講稿放進語料庫的上傳欄就能匯入。這裡的語料庫其實就是帳號底下的練習用講稿清單。所有匯入過的講稿,不論練過沒有,都在這裡管理。
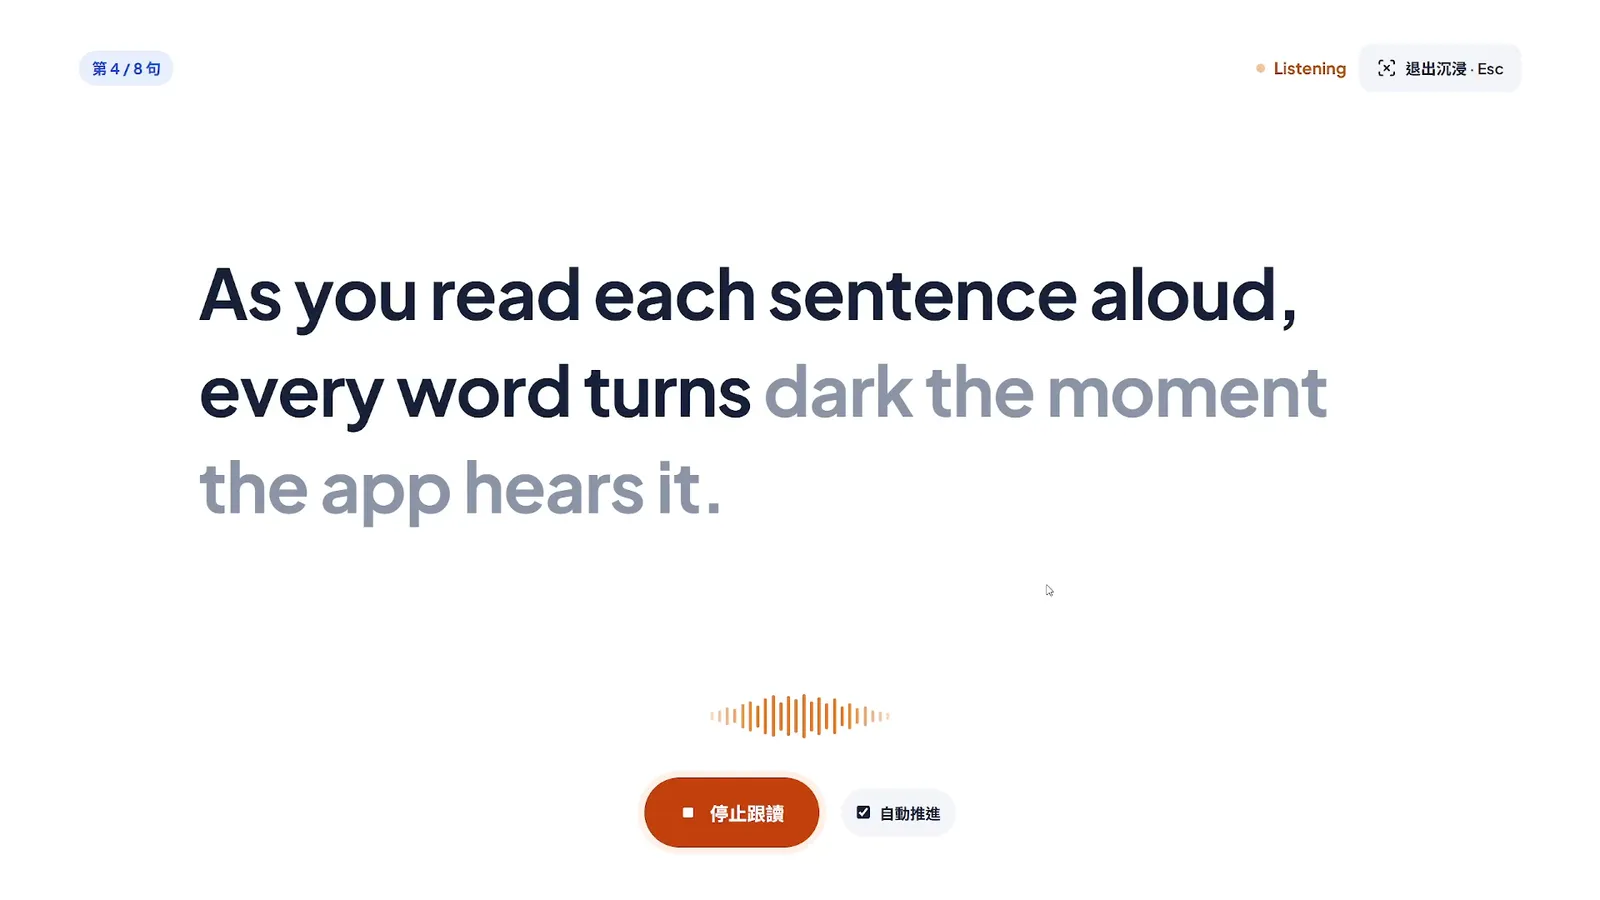
念出來的字,會跟著聲音變深
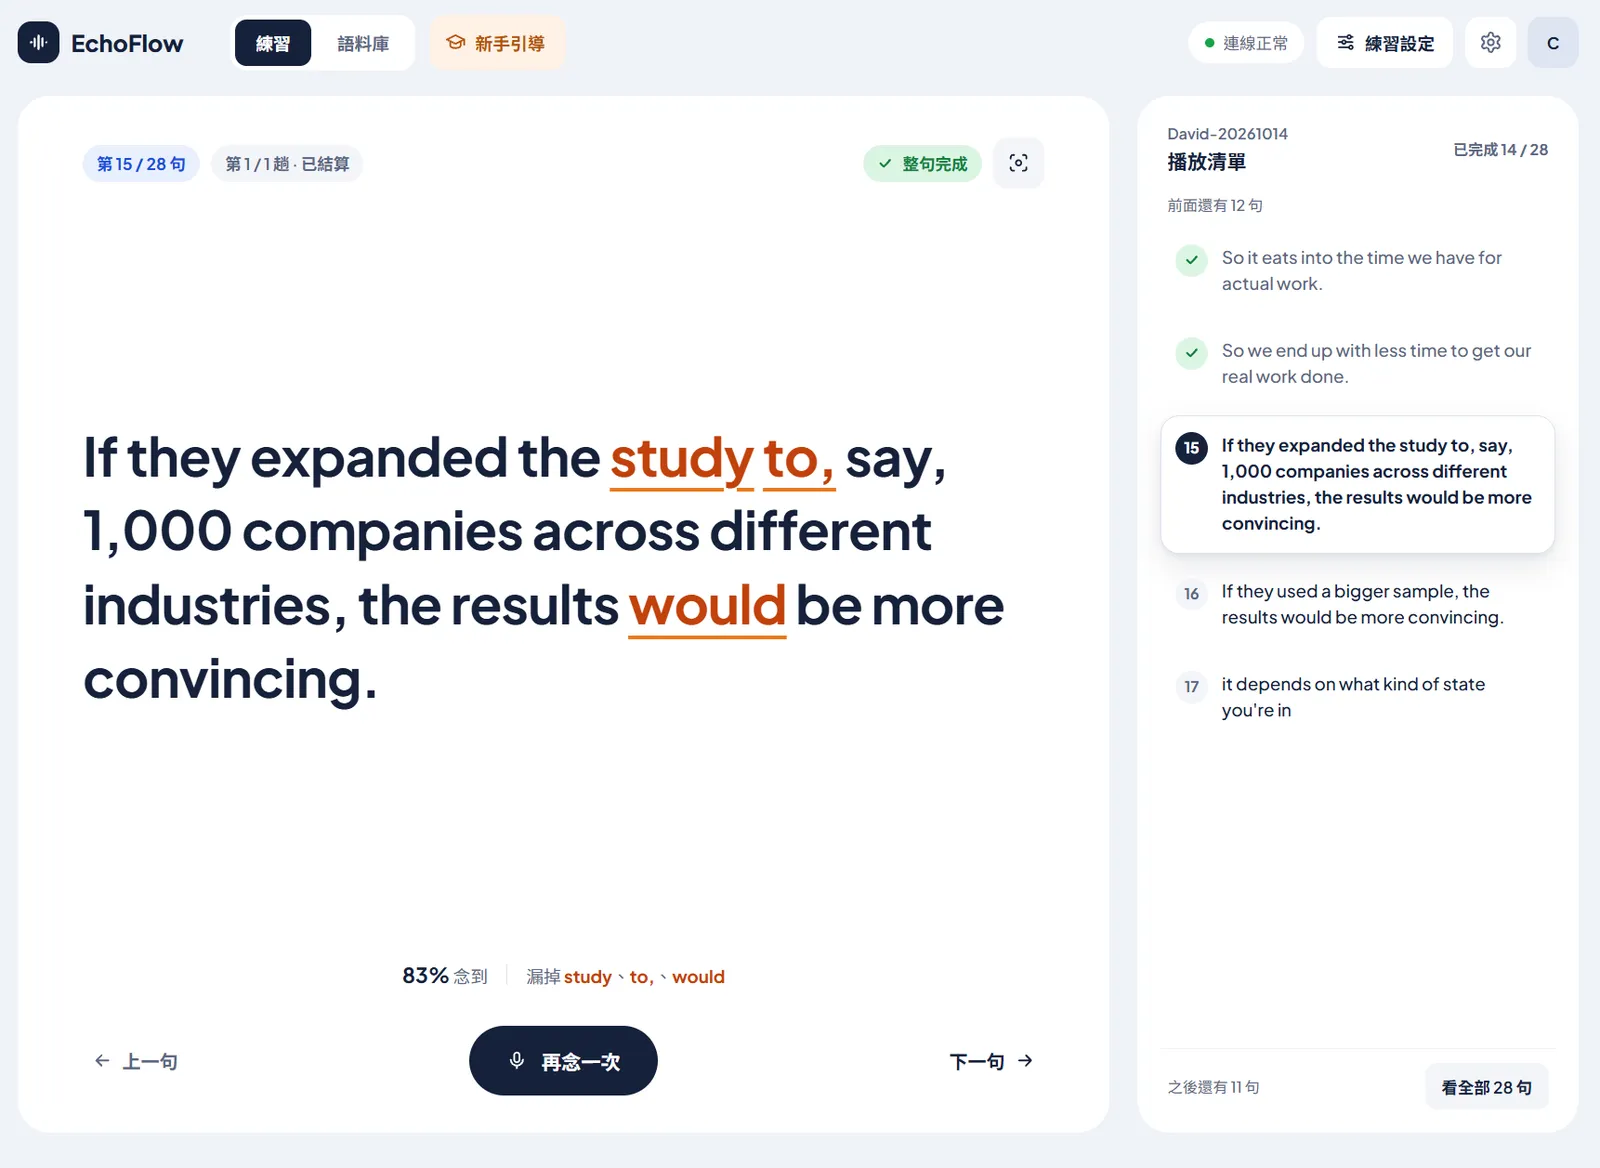
這是整個 App 最核心的功能。按下「開始跟讀」之後,瀏覽器會把麥克風收到的聲音切成很小的片段,即時傳到後端;後端轉給語音辨識服務(我用的是 AssemblyAI),拿回「目前聽出了哪些字」,和講稿對照出我念到第幾個字,再把畫面上的那些字變深。整句念完,漏掉的字會用橘色底線標出來,下方列出這句念到多少、漏了哪幾個字。
在開始動手之前,我就有預感「把辨識結果和講稿對起來」這一關會有很多眉角與難點。表面上只是把聽到的字跟講稿比一比,實際上沒那麼直接:人念稿會漏字、念錯;辨識服務是一邊聽一邊猜,前一刻聽成的字,下一刻可能就被改掉;同一段話用正確的講法,辨識服務寫出來的樣子也不一定和講稿一樣(例如 two 寫成 2、end to end 寫成 end-to-end)。
下面分享一些在實作過程遇到的問題和目前的處理方式。
先決定念到哪裡:只在附近找最像的字
最直覺的做法,是把聽到的整串和整句講稿從頭逐字對照並配對,但這種做法幾乎就是賭使用者按照正確的順序一字不漏地念完練習句。只要中間漏念一個字,後面就全部錯位。
所以我讓程式記住「現在念到講稿的第幾個字」。每聽到一個新的字,只從這個位置往後看幾個字,找出最像的那一個;找到了,就把位置移到它後面。中間被跳過的字,如果是 the、to 這種小字,可以當作念到了;如果是有意義的字,就記成漏念,但繼續往下走,不讓整句卡在原地。
o 念到  ~ 跳過也算念到(取決於嚴格度設定)  x 漏念

講稿範例,假設 ^ 是目前念到的位置
  I went to the store to buy
         ^
聽到的下一個字是 store
往後找,第 3 個字就是它

寬鬆:to、the 都是小字
  I went to the store
  o o    ~  ~   o
標準:只有 the 能跳過
  I went to the store
  o o    x  ~   o
判斷兩個字像不像,我用的是拼寫相似度,介於 0 到 1 之間,一模一樣是 1。練習設定裡的嚴格度,就是讓使用者調整這個相似度的門檻。
講稿 lazy,聽到 lady
拼寫相似度 0.75

寬鬆:門檻 0.70  -> 算念到
標準:門檻 0.80  -> 不算
嚴格:門檻 0.88  -> 不算
除了門檻,嚴格度也決定往後看多遠,以及哪些字可以跳過:寬鬆往後看 5 個字,the、a、to、of、is 這類常見的小字都能跳過;標準看 4 個字,只能跳過 the、a、an;嚴格只看 2 個字,基本上每個字都要念到。
比較特別的是那些超短的字。it 和 its、to 和 too 的相似度都有 0.80,連標準模式都會放行。所以只要有一邊是兩個字母以下的短字,就一定要一模一樣才算。
被記成漏念的字,就是整句念完後畫面上用橘色底線標出來的那些。
這個做法有一個目前還沒解決的問題,是漏念的字補不回來。「念到第幾個字」只會往前走,被跳過的字當下就記成漏念;就算我發現漏了、回頭把那個字再念一次,畫面也不會把它補回來。不過現階段我認為節奏與流暢度更重要,這個問題對於跟讀的練習效果影響不大,所以先放在後續要處理的項目。
辨識服務會邊聽邊改
如同上面提到的,App 把音訊切成很多塊小片段持續送往辨識服務。它一邊聽、一邊把目前辨識出的內容傳回來,辨識服務會自己把話切成一段一段;每次傳回的就是這一段從開頭到現在的完整猜測。隨著句子越念越完整,它也可能依上下文改掉前面的結果:內建的範例練習句裡有一句 Kubernetes and PostgreSQL are two of the technologies that our engineers rely on every day,我念到一半時,它先把 our engineers 聽成 originated,下一次傳回才改成 our engineers。
講稿
  ...that our engineers rely on
第 1 次傳回
  ...that originated
第 2 次傳回
  ...that our engineers
要讓字跟著聲音變深,就不能等整句念完才送去辨識,只能直接拿這些還在變動的結果來比,只是要處理兩件事:
- 每次傳回的都是一整段,前面已經配對過的字不能再比一次。否則假設句子裡出現兩次 the,已經對上第一個 the 的字,下次傳回時又會被拿去對第二個,第二個 the 就被誤算成念到。所以程式會記住這一段已經處理到第幾個字,只比新出現的部分。
- 最後一個對不上的字,可能是我還沒念完,也可能是它等一下會改。這個字先不算數,留到下一次傳回時再比一次。
第 1 次:...that originated
  that 對上,originated 對不上
  -> 先不算,留到下一次再比
第 2 次:...that our engineers
  that 比過了,從 our 開始看
  -> our、engineers 對上,變深
代價是只有最後一個字有重來的機會,更前面的字如果被改掉,不會回頭重比。實際用下來,這家辨識服務很少改動前面已經確定的字,所以這個代價很小。
同一個數字可能有多種表達方式
講稿上寫的是英文單字,辨識服務卻習慣寫成阿拉伯數字。同樣是前面那句 Kubernetes and PostgreSQL are two of the technologies…,我念 two,它寫 2:
講稿  are two of the
聽到  are 2 of the
two 和 2 在拼寫上毫無相似之處,前面講的拼寫相似度完全派不上用場;而且辨識服務什麼時候寫成單字、什麼時候寫成數字,不是我能控制的。
我的做法是,兩邊都是數字時,先把它們換算成數值,只比數值是否相同,不比拼寫。
換算成數值後再比
  two               -> 2
  twenty one        -> 21
  twenty first      -> 21st
  two million       -> 2000000
麻煩的是,同一個數字可能有好幾種念法,年份就是最常見的例子。所以程式換算時,會把一串字所有可能的解讀都算出來,得到一組值;兩邊只要有一個值相同就算數:
2026 可以念成
  twenty twenty six
  two thousand twenty six
兩種念法都換算成 2026
反過來,數值不同就算沒念到。2000 和 2001 的拼寫相似度有 0.75,如果只看拼寫,寬鬆模式會算念到;換算成數值之後就不會。序數和一般的數字也不混用,21st 不等於 twenty one。
另外,我也在產生講稿的 Agent Skill 裡要求 AI 讓講稿裡的數字維持原文,原文寫 2026 就留 2026,不要改寫成英文單字。因為比對時兩種寫法都能互相換算,改寫其實沒有額外的好處。
聽到的是一個字,還是多個字?
講稿和辨識服務對「什麼算一個字」的看法也不一定一樣。舉一個實際例子,end to end 這段話在辨識服務的回傳中,可能會被寫成一個組合字 end-to-end。
講稿上的每個字在畫面上是一格。處理的方式是在連字號(或底線)的地方把它切開,切開之後再一格一格對。
講稿  end to end      (3 格)
聽到  end-to-end      (1 個字)
切開  end | to | end  -> 3 格都對上
同樣的問題在反過來的方向上也可能出現:講稿上的 Speech-to-Text 在畫面上是一格,辨識服務可能把它聽成三個分開的字。所以比對時也允許把聽到的連續幾個字拼起來,再去對講稿上的一格:
講稿  Speech-to-Text  (1 格)
聽到  speech to text
合併  speechtotext    -> 對上
但還有一種情況目前沒有處理:講稿上分開的兩個字,被辨識服務寫成一個沒有符號的字。例如前面那句句尾的 every day,可能被寫成 everyday。
講稿  every day       (2 格)
聽到  everyday        (1 個字)
直覺的解法是把講稿上的 every、day 也拼起來去對。但沒有連字號當線索,程式分不出聽到的字本來就是一個字,還是幾個字黏在一起;如果一律允許這樣拼,聽到的 goat 就可能誤中講稿上剛好相鄰的 go、at。這是目前已知、還待處理的限制。
從開口到字變深,要多久
先看一個字從開口到變深,中間經過哪些地方:
(台灣)瀏覽器:收音,切成小片段送出
    | 連線 A:瀏覽器 ↔ 後端的 WebSocket
    v
(台灣)後端 Cloud Run:接收音訊並轉發
    | 連線 B:後端 ↔ 辨識服務的 WebSocket(官方 SDK)
    v
(美國)AssemblyAI 辨識服務:把聲音轉成文字傳回
    | 由連線 B 傳回
    v
(台灣)後端 Cloud Run:和講稿對照,算出念到哪
    | 由連線 A 傳回
    v
(台灣)瀏覽器:把念到的字變深
部署到雲端後,我念的時候體感延遲大約 600 到 800 毫秒,字還跟得上嘴巴。
這段時間有一大塊花在地理距離上。後端在台灣、辨識服務在美國,而 AssemblyAI 目前沒有亞洲的服務端點:就算一切順利,一個字通常也要 300 多毫秒才會變深,其中光是橫越太平洋來回就占了大約 180 毫秒。剩下的時間主要在等辨識服務把結果傳回來;我試著調過它提供的幾個參數,目前還沒找到能讓字明顯早一點變深的設定。
另外,字也不是一個一個變深的。前面提過,辨識服務會把話切成一段一段;一段裡最後念的那個字等得最短,大約 240 到 420 毫秒,段落中間的字往往要等這一段收尾才會變深。所以畫面上的字是一叢一叢地變深,不是一個字一個字跟著嘴巴走,開頭的 Demo 影片可以看到這個節奏。
照自己的節奏練
我認為跟讀的過程,節奏感非常重要,同時透過看著文字主動開口,把句型結構和嘴巴的發音連起來。另外還有念完句子之後的回饋,都是使用者體驗上很重要的一部分(我覺得念完後的提示音,就是 Speak 讓人上癮的原因之一 XD)。
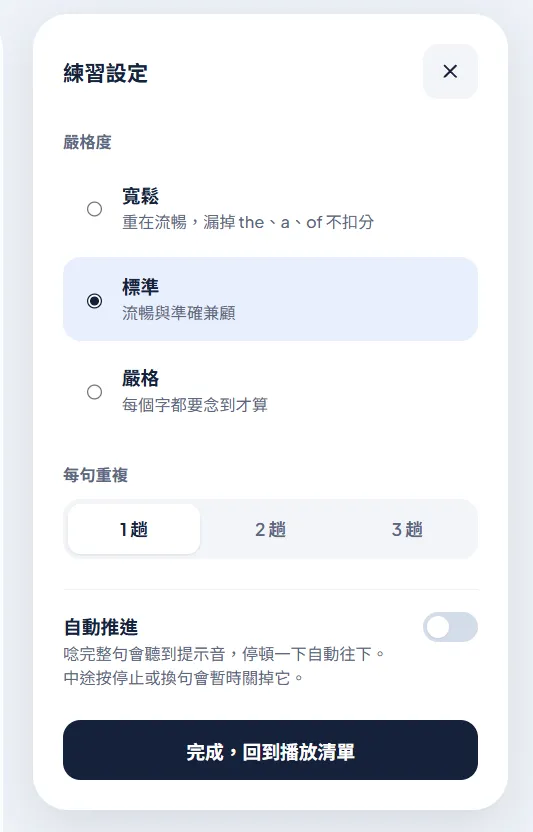
練習設定裡可以調三件事。嚴格度分三段:寬鬆重在流暢,漏掉 the、a、of 這類小字不算漏;標準兼顧流暢與準確;嚴格則每個字都要念到才算。嚴格度越高,我會刻意念得慢一點、完整一點;但也越容易漏念,或發音被判定不對,整體節奏自然就會受影響。所以我實際大多只用寬鬆和標準:想快速順過一遍時用寬鬆,想認真確認自己念得完整時用標準;嚴格模式主要是開發時測試用的。
另外,每句可以重複 1~3 趟。打開「自動推進」後,念完一整句會聽到提示音,停頓一下就自動換到下一句,整篇念下來不用動手。這些設定有不少靈感來自 Speak,但我想做得更能自訂。
想專心的時候可以切到沉浸模式,搭配設定好的自動推進,就能完全不用操作、只專心跟念。開頭的 Demo 影片就是在這個模式下錄的。
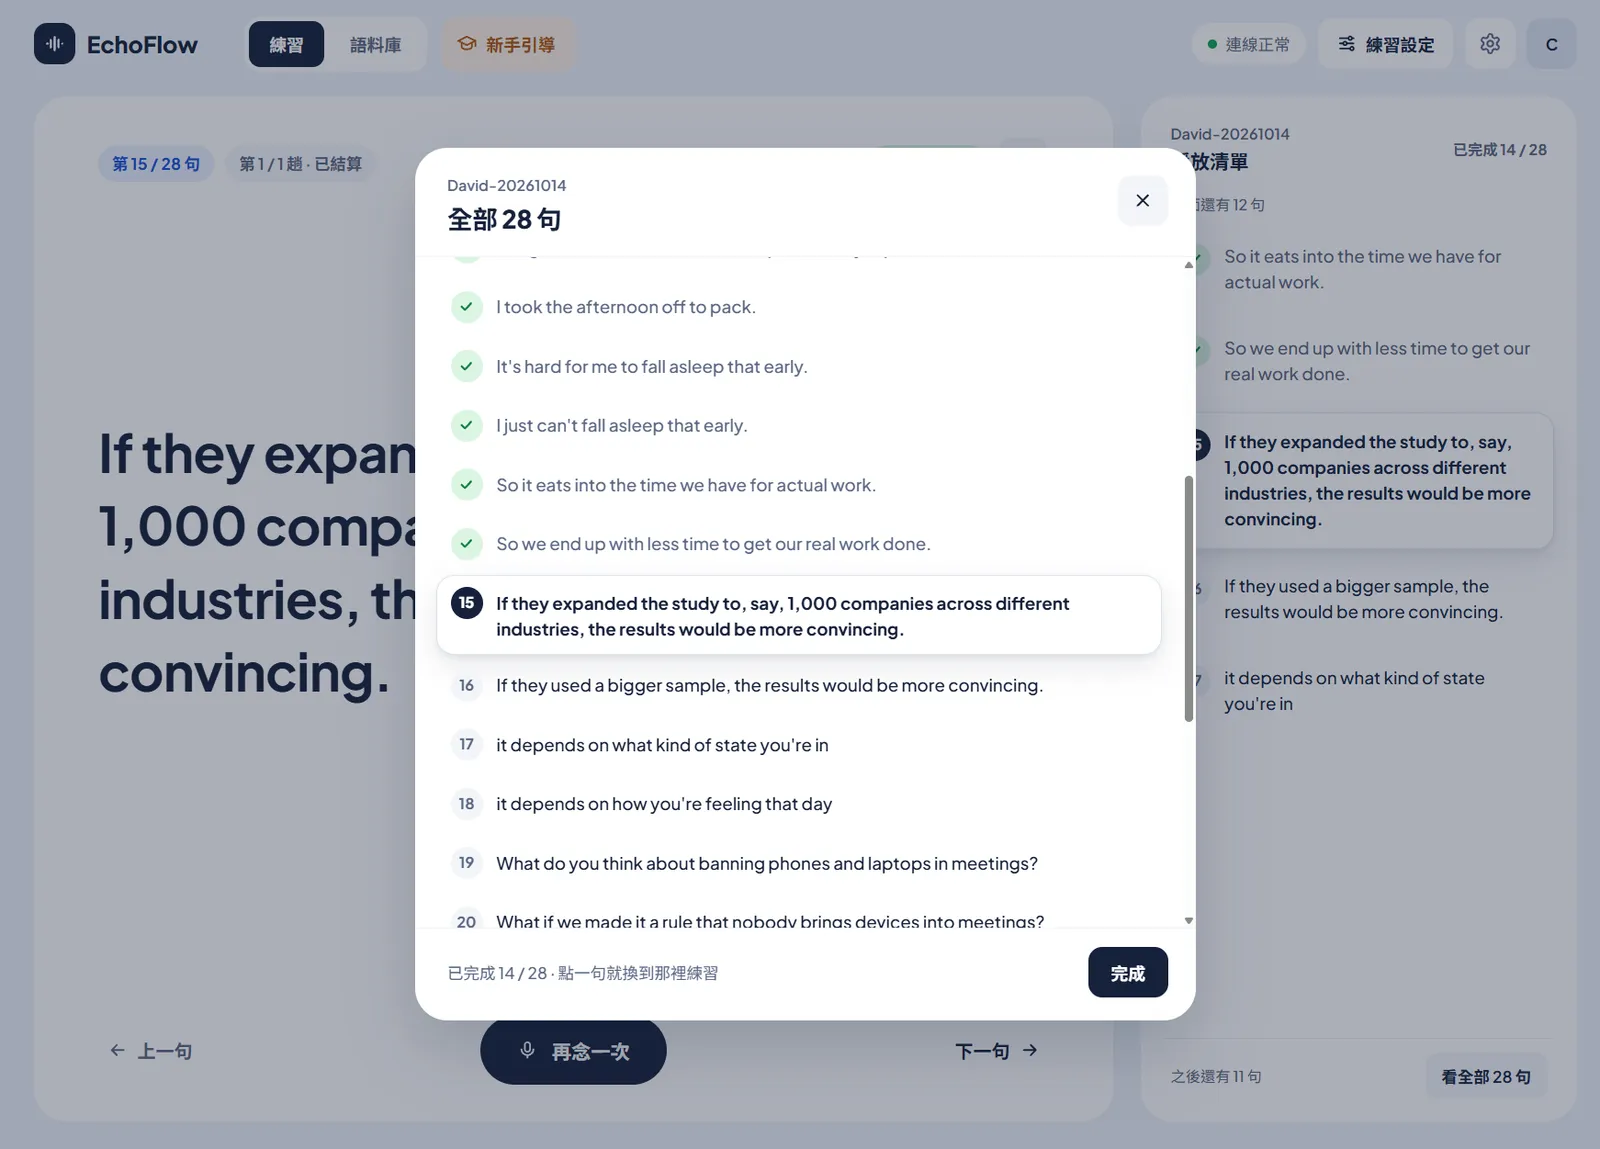
練習時,右側的播放清單會跟著目前這句移動,練滿設定趟數的句子會打勾;點「看全部」可以打開完整的句子清單,點一句就跳過去練。這是 Speak 沒有,但我只想練特定段落時很有用的功能。
念完一篇,結算練習的成果
念完一整份講稿後,結算畫面會列出這一輪念出了多少字、哪些字沒念到,以及每一句的結果。沒念到的字,可能是不會念,也可能是念的時候漏掉、或講得不清楚而沒被辨識出來。
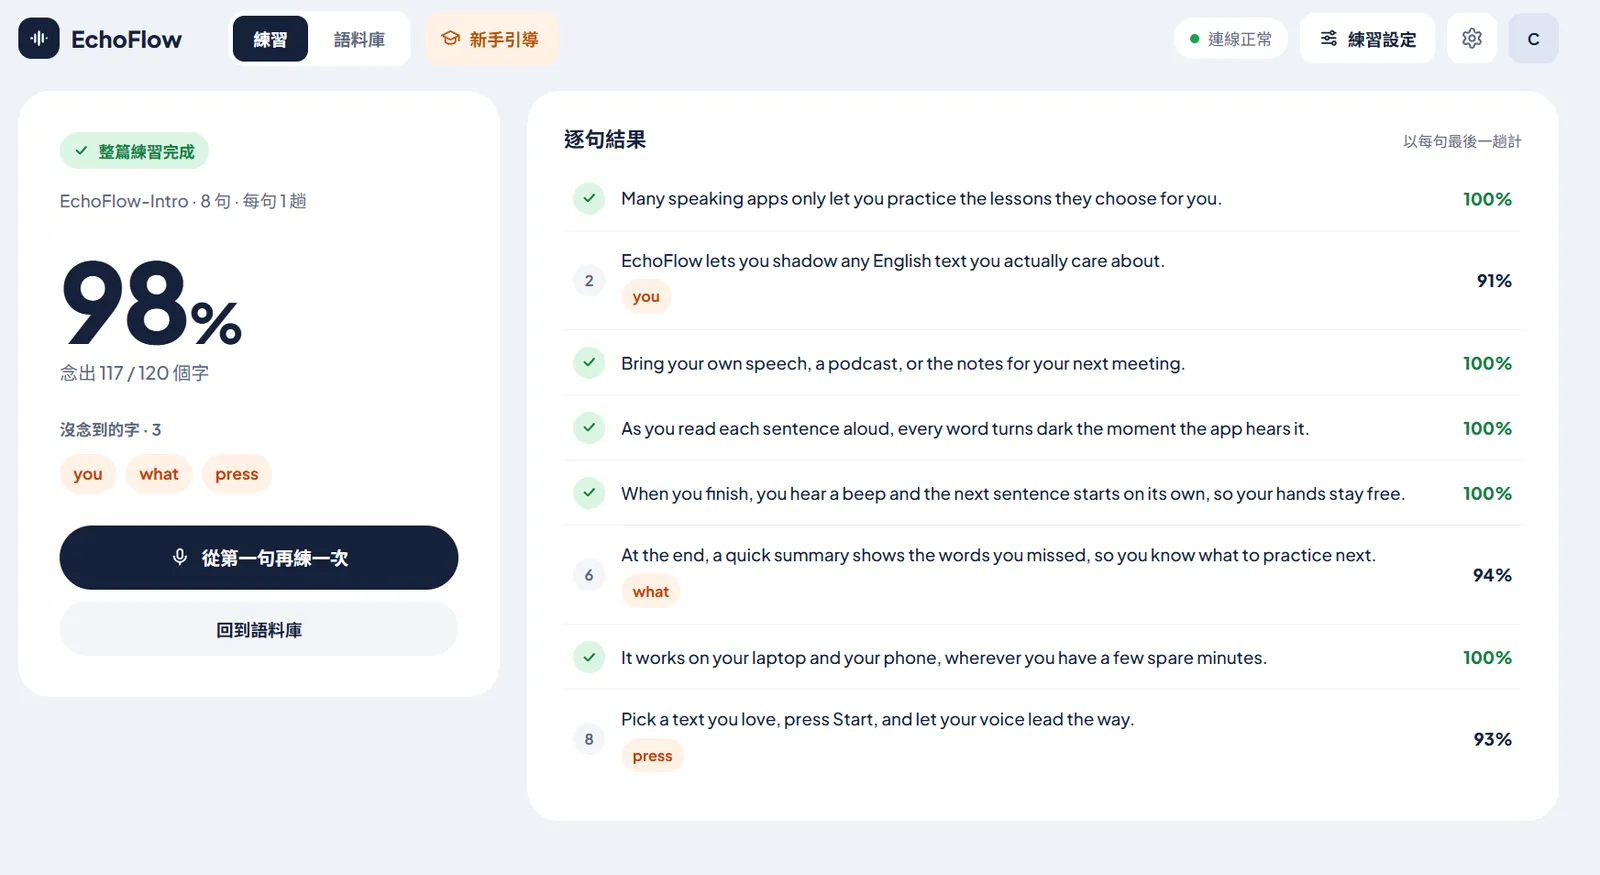
這個結算畫面真正的價值,在於之後能延伸出來的功能。
Speak 雖然沒有類似的結算頁,但在 AI 問答這類模式下,會把我犯的部分錯誤整理成練習句,這是 Speak 很不錯的一個功能。
EchoFlow 目前還沒有類似的功能,但錯誤結算就是這類功能的地基:記下使用者長期犯的錯,透過 AI Agent 整理或統計,甚至產出複習用的講稿,這方面的擴充還有很多想像空間。
不過在 App 裡做出來之前,我已經在 App 外,用另一個專案做到了類似的事。只是整理的不是跟讀時念錯的字,而是我在 Cambly 課堂上講錯的句子。
把課堂上講錯的句子,變成下一份講稿
我自己最常練的素材主要來自每週的 Cambly 英文家教課。
在課堂上,大部分 Cambly 老師都會以鼓勵學生多開口為主,因此只要聽得懂意思且不是很大的語法錯誤,大多老師們不會直接打斷對話來修正。
實際上這也是我要的,因為我通常也會和老師們清楚表達我想要多練日常對話、主題討論,盡可能專注在流暢度與確實表達想法上。
但這也代表,幾乎大部分老師在我的文法錯誤或用詞不夠準確時,只要還能理解我想表達的意思,我們的對話就繼續前進了。許多時態、介系詞,或是我在處理比較複雜句子時仍會在腦中直接中翻英的壞習慣就很容易一犯再犯,甚至被我變成慣用法。
為了複習這些錯誤,當時我寫了 Cambly-transcriptionist 這個專案。
用來在課後整理對話,並交由 AI 去分析我的錯誤習慣、句子結構或不準確的用詞,再整理成附帶修正句的複習文件。
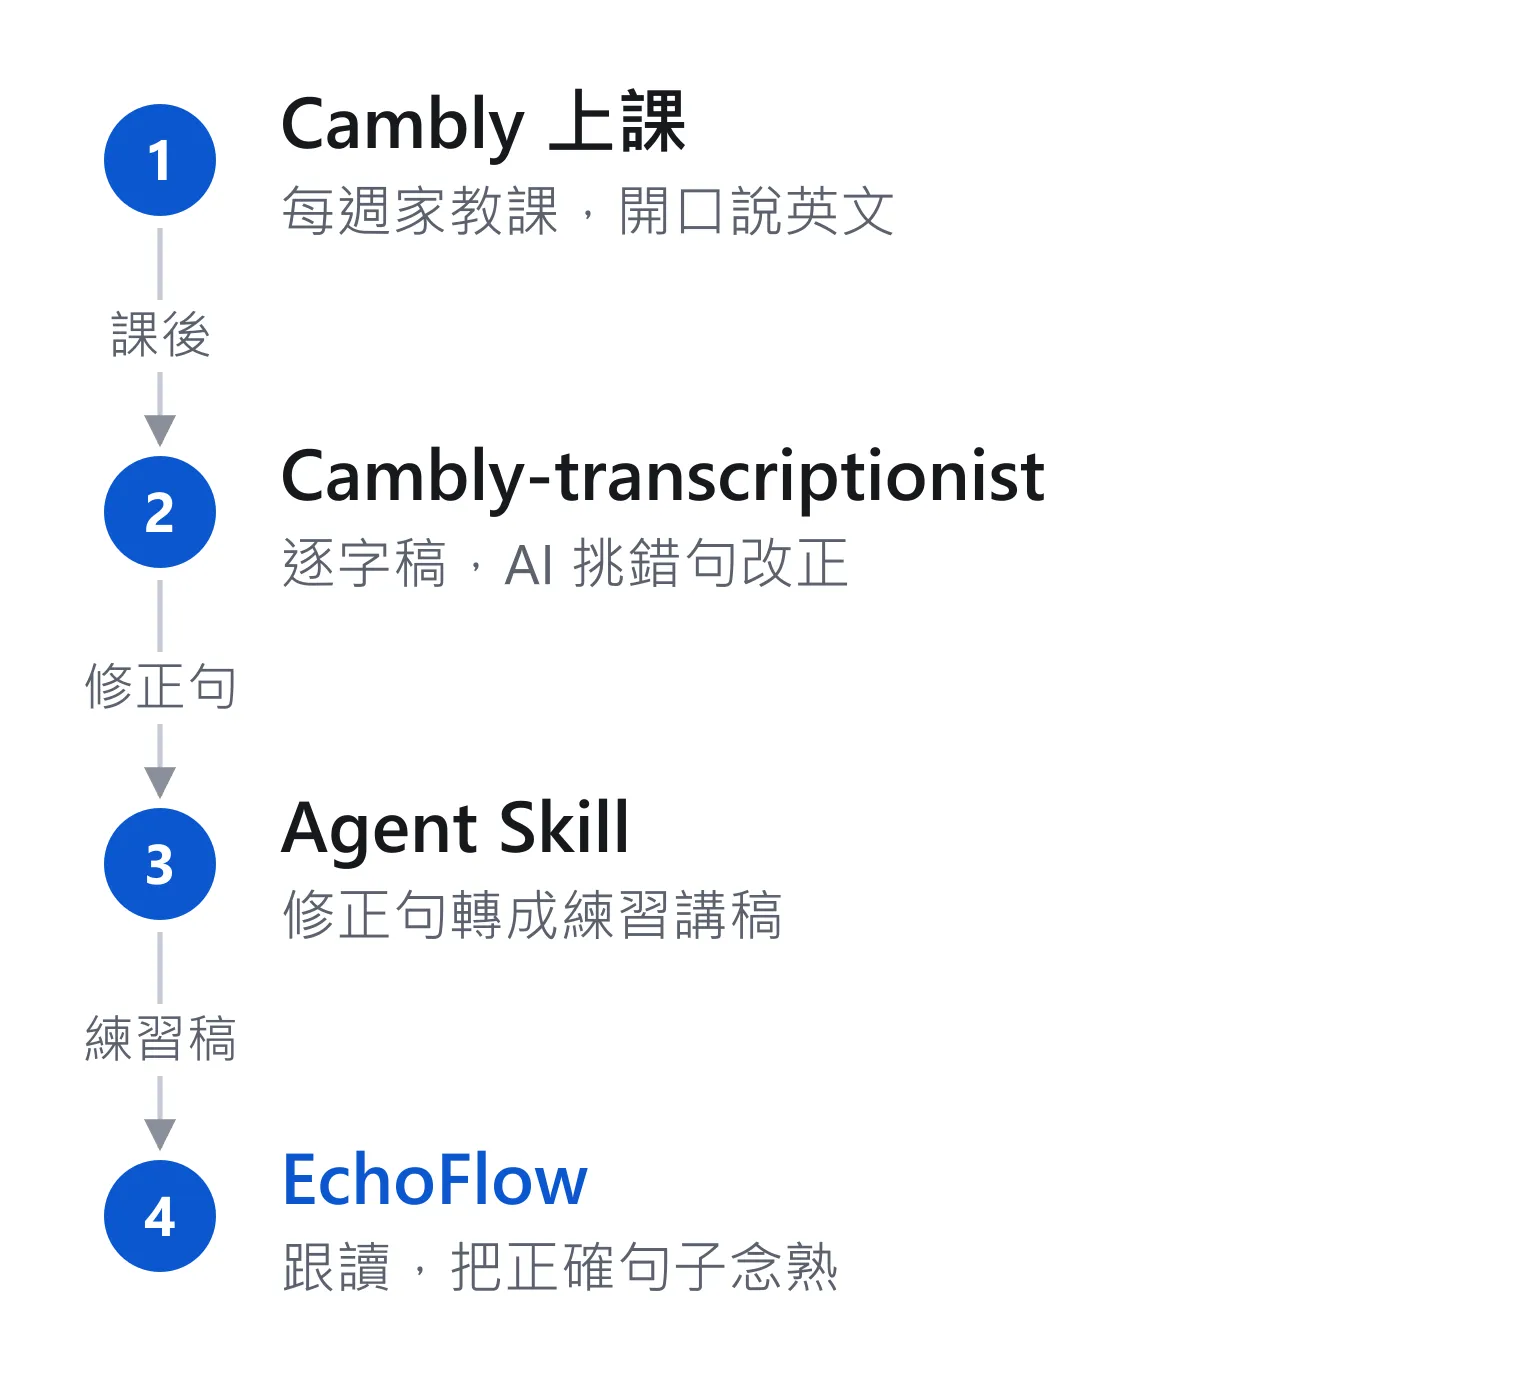
這本來是兩個不相干的專案,但恰好在完成後可以被串成一條流程:修正後的句子透過前面提過的 Agent Skill 轉成講稿,就能直接匯入回到 EchoFlow 來複習。語料庫截圖裡面以老師和日期命名的講稿就是這樣來的。
我對 Cambly 上課的完整心得,先前整理在 Cambly 上課心得 這一篇。